[2/2] AI-native организация: от сигнала до действия (Рубрика #Management)
Хочу продолжить мысль про координацию из предыдущего поста про Organizing Intelligence, но на уровне целой компании. Это продолжает идеи и восьмого выпуска 3 AImigo «AI-native: что это значит для компании?», где мы с Алексеем Литвиновым и Евгением Сергеевым обсуждали общий контекст, перестройку процессов и очередь вопросов к человеку. Здесь хочу проверить эту рамку на одном сквозном примере.
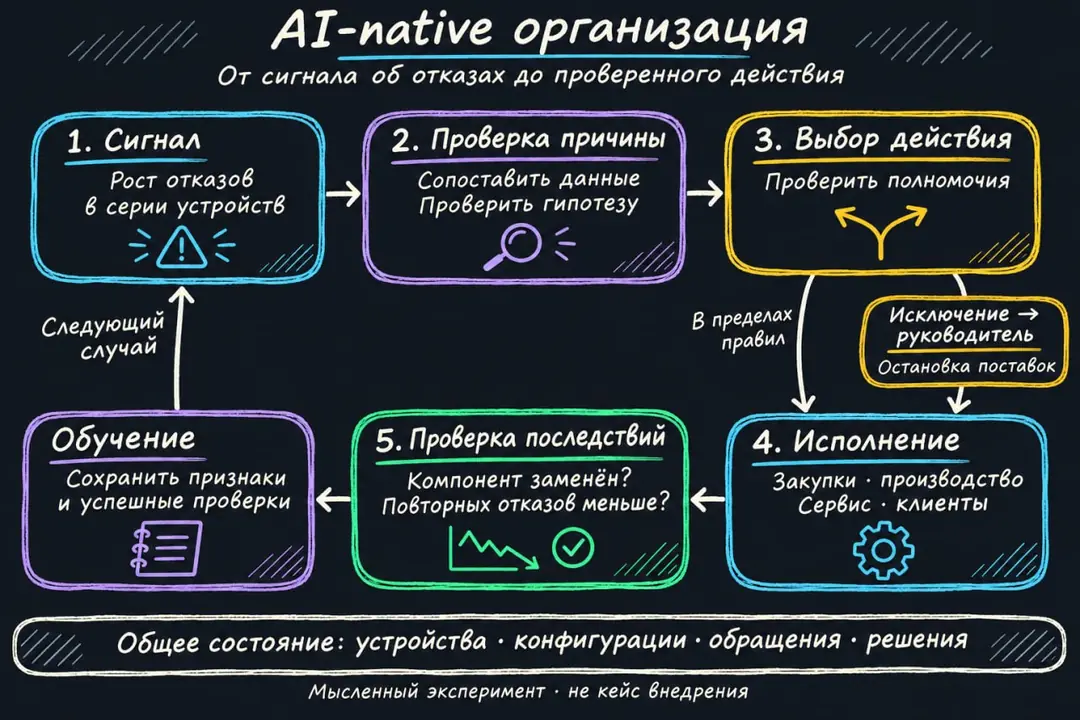
Представим производителя промышленного оборудования. Сервис замечает рост отказов у одной серии устройств. AI помогает найти закономерность, инженерам — проверить гипотезы, поддержке — подготовить ответы клиентам. Но вопрос об остановке поставок всё равно ждёт директора. Исполнение ускорилось, а очередь решений осталась.
Для этого примера я бы определил AI-native организацию через способность перестраивать весь цикл работы с учётом доступного искусственного интеллекта: Сигнал → проверка причины → выбор действия → исполнение → проверка последствий.
Что потребуется, чтобы такая цепочка работала при росте нагрузки?
🔸Связанное состояние компании Обращения клиентов должны сопоставляться с серийными номерами, конфигурациями, условиями эксплуатации и инженерными изменениями. У гипотезы должны быть основания и статус проверки. Иначе агенты могут очень быстро разнести по отделам одну и ту же ошибку.
🔸Явные полномочия Например, система вправе назначить дополнительную диагностику в пределах бюджета. Остановку поставок рассматривает ответственный руководитель. Для каждого перехода нужны условия, срок реакции и понятный путь эскалации. Если любое действие требует согласования у одного человека, добавление агентов увеличит его очередь.
🔸Проверяемое исполнение Решение «заменить компонент» должно дойти до закупок, производства, сервисных процедур и обязательств перед клиентом. Закрытая задача в трекере ещё оставляет вопрос: нужная деталь действительно установлена и повторные отказы стали реже?
🔸Обучение на последствиях После устранения проблемы стоит сохранить признаки отказа, отвергнутые гипотезы и проверки, которые сработали. Тогда следующий случай получит готовые инструменты. Только придётся следить за их актуальностью: старая диагностика для новой конфигурации тоже может стать источником ошибок.
В такой схеме меняется и работа руководителя. Я бы оценивал его вклад через качество правил делегирования, решений в спорных ситуациях и способность убрать зависимость процесса от собственного постоянного внимания. Количество обработанных согласований легко растёт вместе с плохо устроенным процессом.
Как проверить, помогает ли эта архитектура? Увеличить число одновременно разбираемых случаев и посмотреть на время до проверенного действия, полную стоимость результата, повторные отказы и число ручных исключений на случай. Отдельно учесть вычисления и человеческое внимание.
Это ещё не доказательство прохождения порога supercooperative из статьи. Но вполне конкретная проверка для AI-native организации: если поток проблем удвоился, получится ли удержать качество без удвоения очереди к руководству?
#Management #AI #Agents #Architecture #Metrics